AI模型评测共12条
CLUE中文语言理解基准测评16小时前
中文语言理解测评基准,包括代表性的数据集、基准(预训练)模型、语料库、排行榜。选择一系列有一定代表性的任务对应的数据集,做为我们测试基准的数据集。这些数据集会覆盖不同的任务、数据量、任务难度。
2次浏览直达
FlagEval (天秤)大模型评测16小时前
FlagEval (天秤)大模型评测体系及开放平台,旨在建立科学、公正、开放的评测基准、方法、工具集,协助研究人员全方位评估基础模型及训练算法的性能,同时探索利用AI方法实现对主观评测的辅助,大幅提升评测的效率和客观性。
2次浏览直达
C
CLiB中文大模型能力评测榜单16小时前
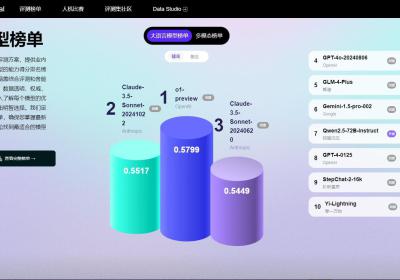
是一个关于中文大模型能力评测的榜单仓库,涵盖 195 个商用及开源大模型,进行多维度能力评测(包括医疗、教育、法律等众多领域),有多种排行榜分类且记录详细更新信息。
2次浏览直达