网站信息
FlagEval 大模型评测
说到使用者痛点,你是否也深陷大模型选择的困境?其实,
者和公司往往面临着以下困扰:
- 评测标准不一:市面上榜单眼花缭。缺乏统一的标准,难以判断哪个模型真正适合自己的业务。不过,
- 评估成本极高:手动测试耗时耗力。依靠人力评测无法跟上模型快速迭代的速度。
- 主观性过强:感性评测往往受主主观影响。缺乏量化的数据支撑,决策风险大。
- 能力边界模糊:无法细粒度地掌握模型在逻辑、代码、多模态等特定能力上的真实极限。不过,
FlagEval 大模型评测程序及开放网站,旨在建立科学、公正、开放的评测基准、方法、工具集。 协助研究人员全方位评估基础模型及训练算法的性能,同时探索利用AI方法实现对主观评测的辅助,明显提高评测的效率和客观性。FlagEval 创新的认知能力边界,可视化呈现评测结果。
再看主要优势。全方位的科学评估
目前已推出语言大模型评测、多语言文图大模型评测及文图生成评测等工具,并对广泛的语言基础模型、跨模态基础模型实现了评测。后续将覆盖更多基础模型、预训练算法、微调/压缩算法等三大评测对象,包括自然语言处理、计算机视觉、音频及多模态等四大评测场景和丰富的下游任务。
FlagEval 是智源FlagOpen大模型开源技术程序的关键组成部分。FlagOpen 旨在建立全面支撑大模型技术发展的开源算法程序和一站式基础软件网站。支持协同创新和开放竞争,共建共享大模型时代的“Linux”开源开放环境。
推荐指数:★★★★☆
最佳使用场景:大模型选型、算法性能调优、多模态能力边界探索
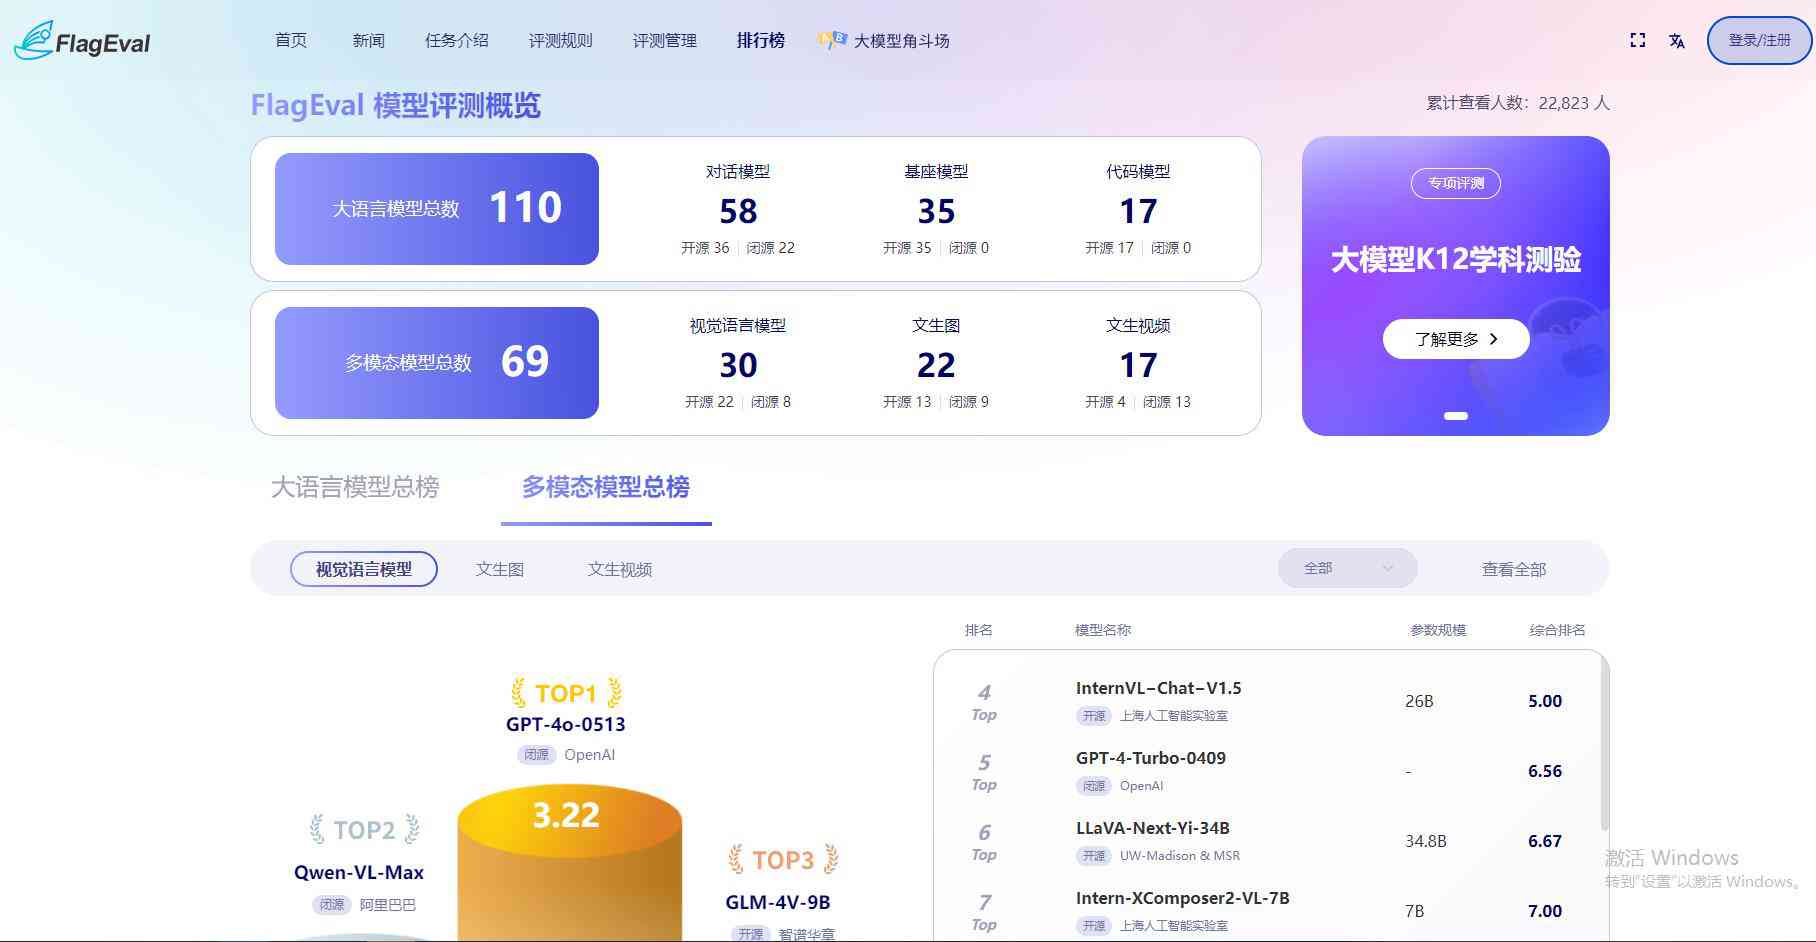
以下为2024年9月截取的图片。模型排名可能因为日期不同而不同,截图仅供参考,具体以网站内为准:
类似工具
Deepseek高级指令词Deepseek高级指令词,开启Deepseek神秘功能,精选Deepseek指令词大全,提供Deepseek高级指令词、顶级指令词、Deepseek指令话术,超好玩的Deepseek指令库,让你充分发挥Deepseek能力!以及神秘功能!
官网入口O
OnepinOnepin,自动校验发音的AI配音生产工具,Onepin是一个AI配音“生产”工具,它不是又一个TTS模型,而是站在三十多个TTS模型前面做调度和质检。你把脚本丢进去,它会逐句把文本路由到最合适的模型,生成后自动检查,再把读错的地方修掉,
官网入口H
HolgoHolgo,拍几张照片生成电商商品详情,Holgo是给二手和手工卖家用的AI商品文案工具。给一件商品拍几张照片,正面、侧面、标签、有瑕疵的地方都拍上,它会把这些照片放在一起看,生成一整套可以直接上架的商品详情。 目前支持Etsy、eBay、
官网入口M
MaxworkerMaxworker,住在Slack里的AI同事,Max是一个装在Slack里的AI同事,官网域名是maxworker.ai。你在Slack里直接@它或者私信它派活,它会去团队已经在用的工具里收集上下文,交回报告、草稿、摘要和下一步建议。 典
官网入口