网站信息

Seed-TTS
Seed-TTS 是字节跳动 Seed 团队发布的语音生成研究成果。定位为一组大规模文本转语音模型,目标是在自然度、表达力和说话人相似度上接近真人语音。它支持基于短语音样本进行零样本语音克隆,并具备情感和表达控制潜力。
该项目主要以技术报告、论文和 Demo 形式公开,适合关注高质量 TTS、虚拟助手、有声书、视频配音和语音编辑的研究者与开发团队。
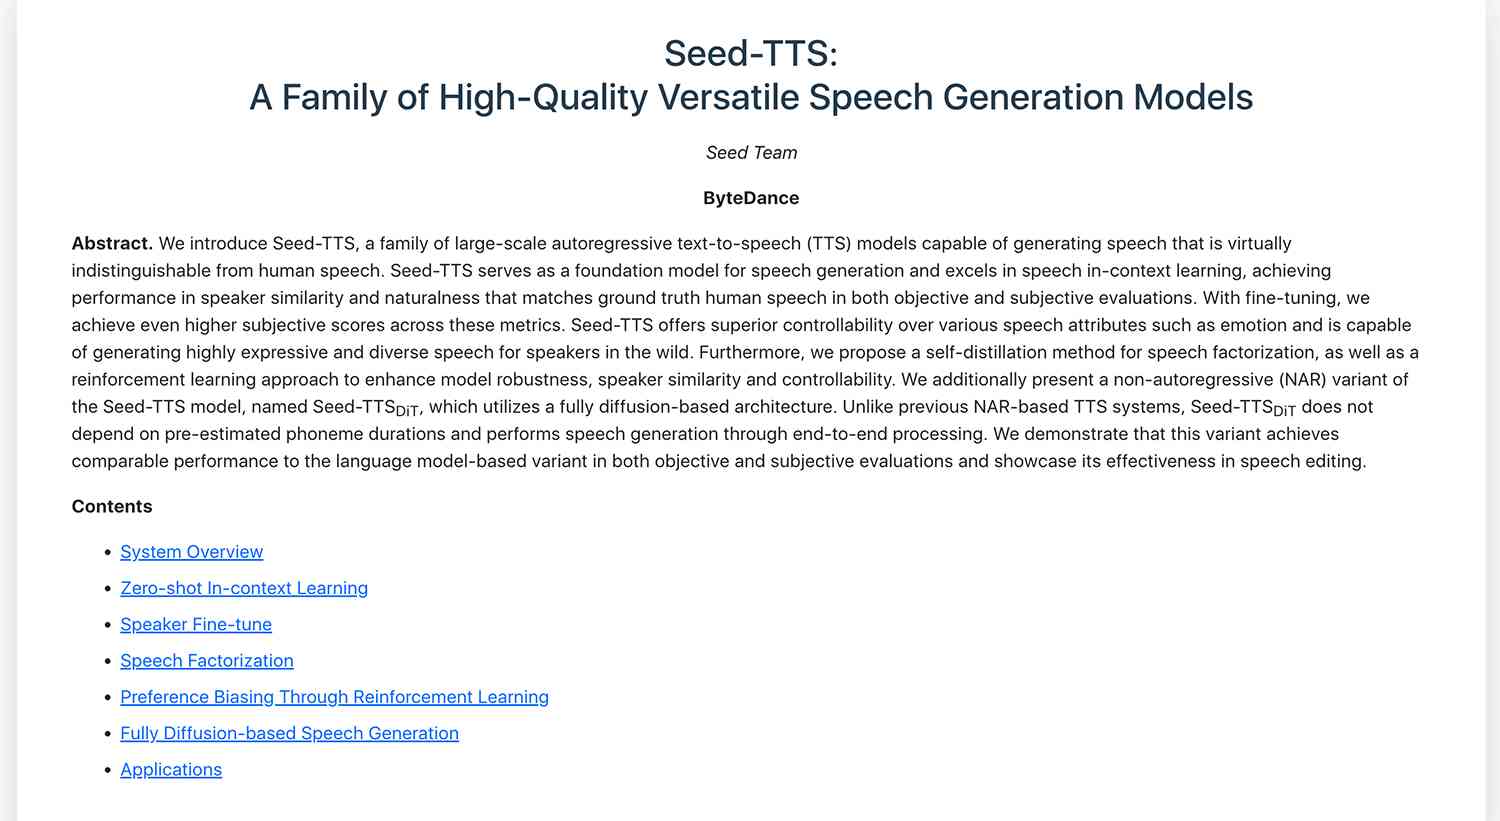
高自然度 TTS:生成接近真人自然度和表达力的语音,适合旁白、对话和音频内容。
零样本音色克隆:可基于短录音样本合成相似说话人的语音。
语音属性控制:支持对情绪、表达和说话风格等语音属性进行更细粒度控制。
语音编辑研究:包含非和编辑探索。
Seed-TTS适用场景
适合音频应用开发者、视频创作者、数字人团队和语音技术研究人员,尤其适用于追求高自然度和个性化音色的语音生成任务。可用于视频旁白、角色配音、对话音频、数字人声音还有。
推荐指数这方面,
★★★★★
再看最佳使用场景。
适合音频应用开发者、视频创作者、数字人团队和语音技术研究人员。
官网地址
Seed-TTS官网地址:https://bytedancespeech.github.io/seedtts_tech_report/
类似工具


