MiniGPT-v2多模态翻译站点
因为GPT-4V多模态模型的发布。具备图像识别的大语言模型,正在成为未来的趋势。最近KAUST 团队还有来自 Meta 的研究者宣布,他们将 MiniGPT-4 重磅升级到了 MiniGPT-v2 版本。
论文地址和其他资源
痛点与方法
痛点:传统的视觉语言模型往往需要分别处理图像和文本输入,这会导致复杂度和效率问题。方法:MiniGPT-v2 提出了一种统一的接口来处理各种视觉语言任务。使得模型能更好地理解图像和文本之间的关系,从而提高任务的学习效率。
实验结果
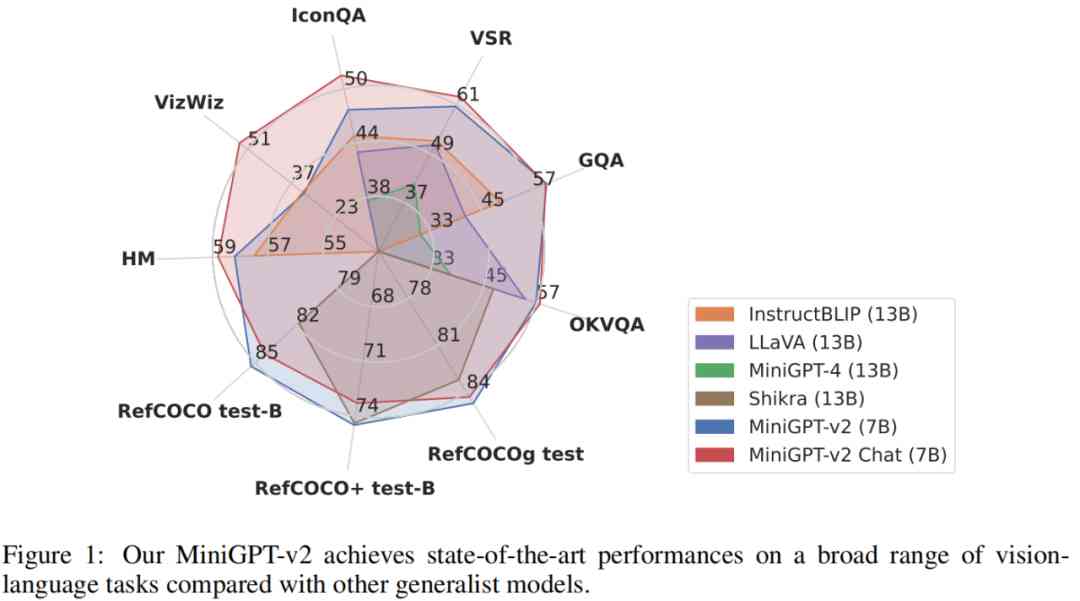
为了评估 MiniGPT-v2 模型的性能,研究者对不同的视觉语言任务进行了广泛的实验。其实,结果显示,与之前的视觉语言通用模型相比。MiniGPT-v2 在各种基准上实现了 SOTA 或相当的性能。例如在 VSR 基准上,比 MiniGPT-4 高出 21.3%。比 InstructBLIP 高出 11.3%,比 LLaVA 高出 11.7%。
模型架构
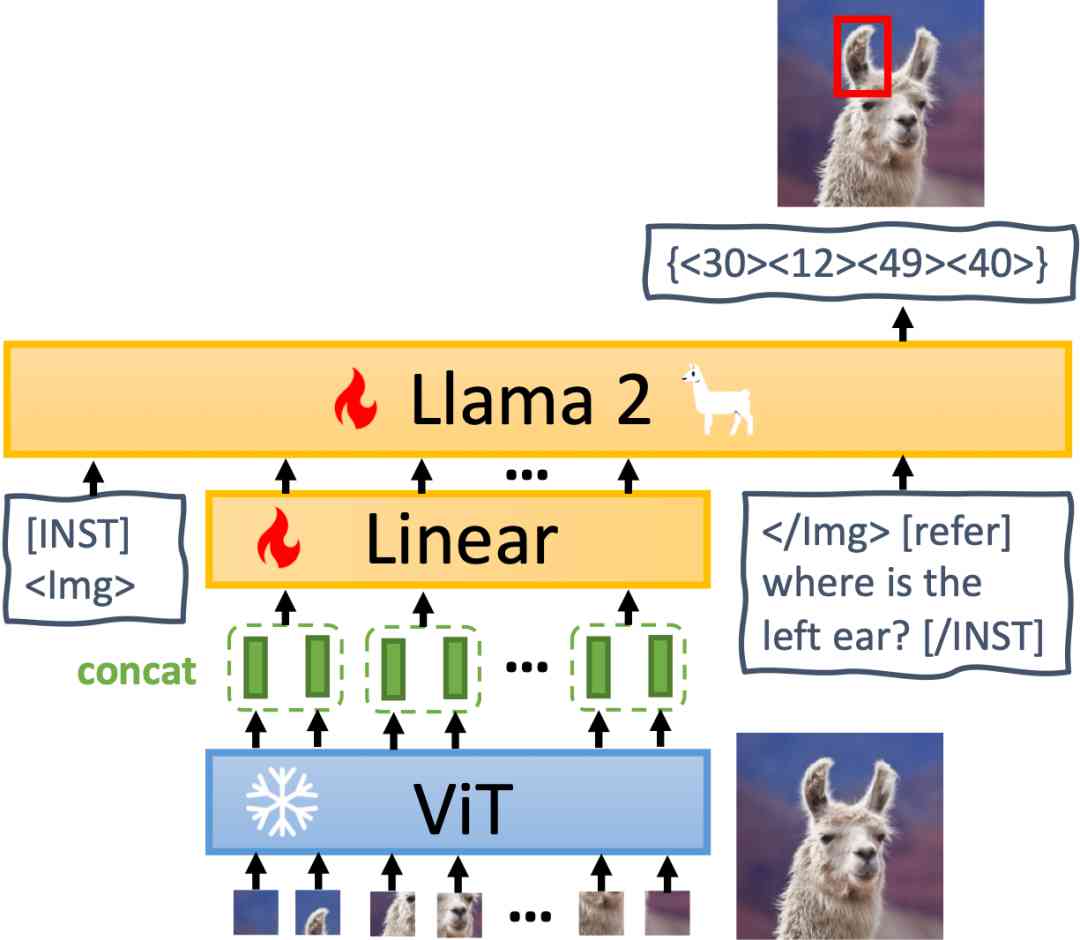
MiniGPT-v2 模型架构如下图所示,它由三个部分组成:视觉主干、线性投影层和大型语言模型。
具体设计细节
视觉主干:- MiniGPT-v2 采用 EVA 作为主干模型,而且在训练期间会冻结视觉主干。 - 训练模型的图像分辨率为 448×448,并插入位置编码来 更高的图像分辨率。
线性投影层:- 主要想说明将所有的视觉 token 从冻结的视觉主干投影到语言模型空间中。- 对于更高分辨率的图像。投影所有的图像 token 会导致非常长的序列输入,显着降低了训练和推理效率。这篇文章简单地将嵌入空间中相邻的 4 个视觉 token 连接起来并将它们一起投影到大型语言模型的同一特征空间中的单个嵌入中,从而将视觉输入 token 的数量减少了 4 倍。按理说,
大型语言模型:- MiniGPT-v2 采用开源的 LLaMA2-chat 主干。怎么说呢,在该研究中,语言模型被视为各种视觉语言输入的统一接口。这篇文章直接借助 LLaMA-2 语言 token 来执行各种视觉语言任务。对于需要生成空间位置的视觉基础任务,这篇文章直接要求 language 模型生成边界框 的文本表示以表示其空间位置。
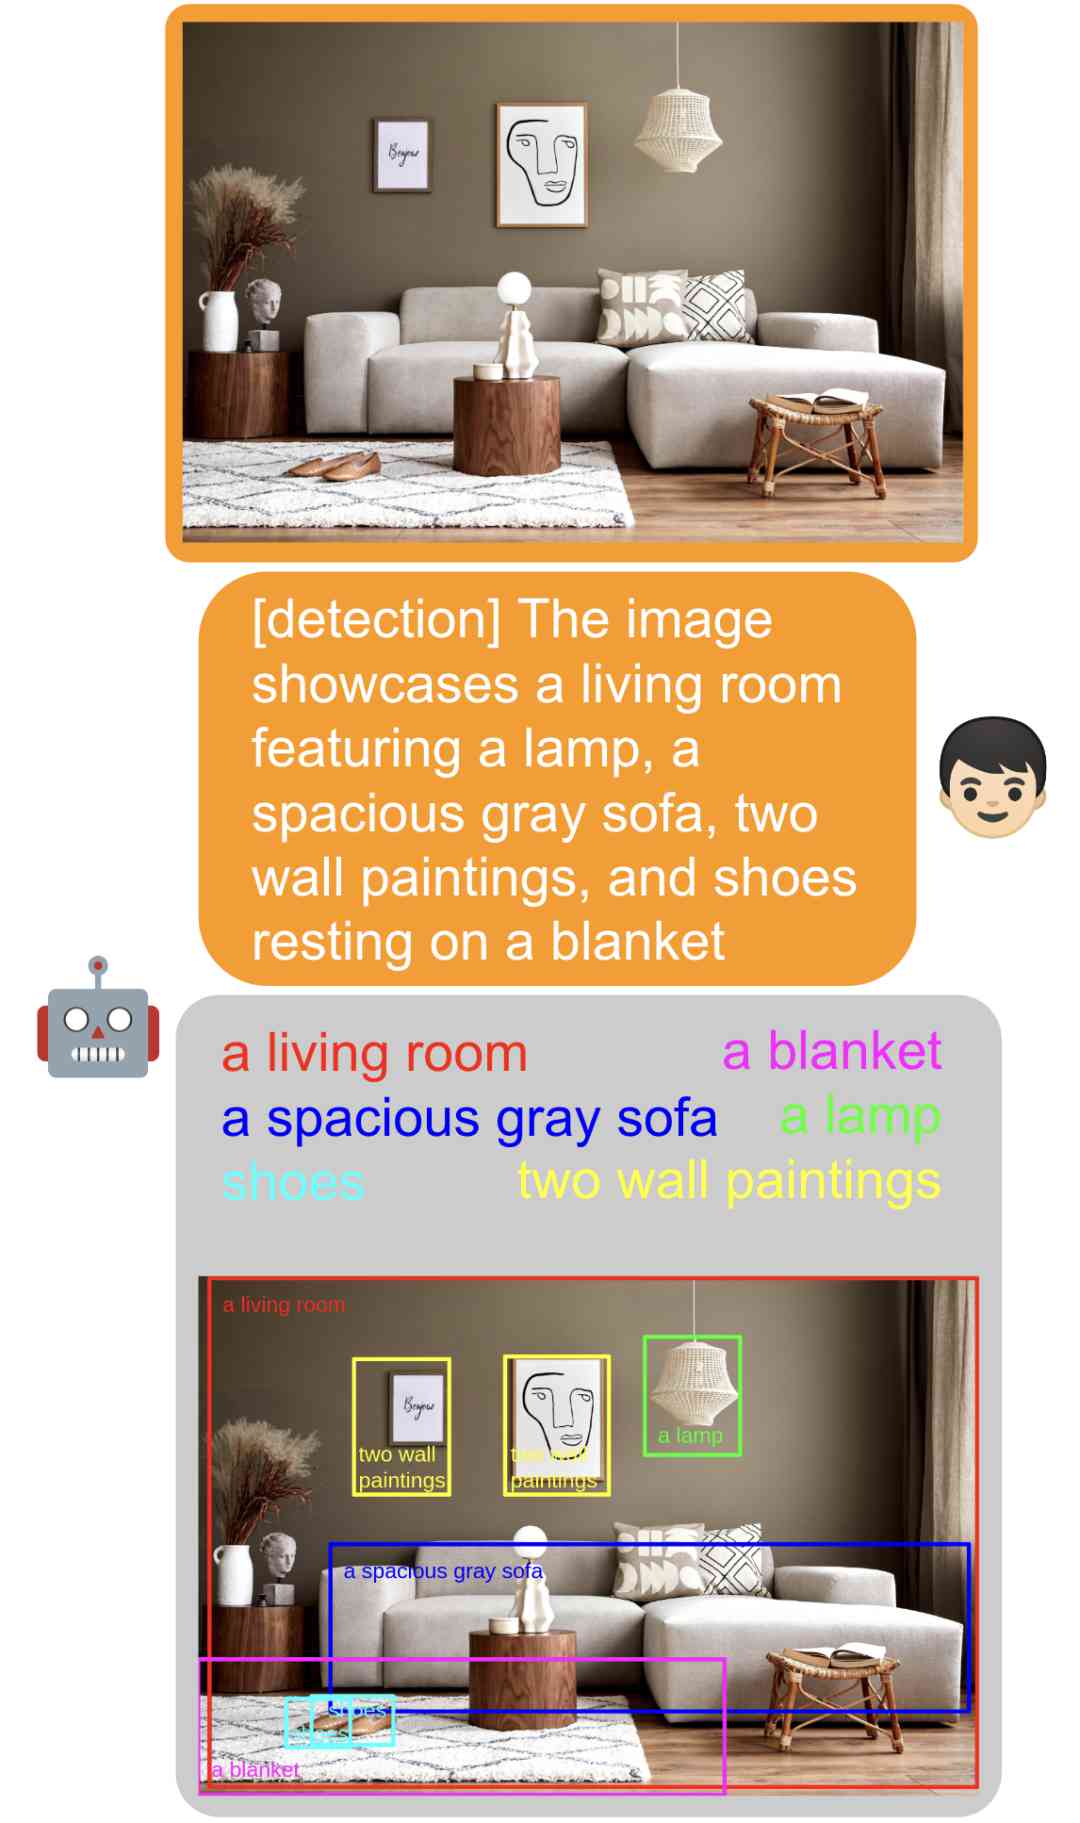
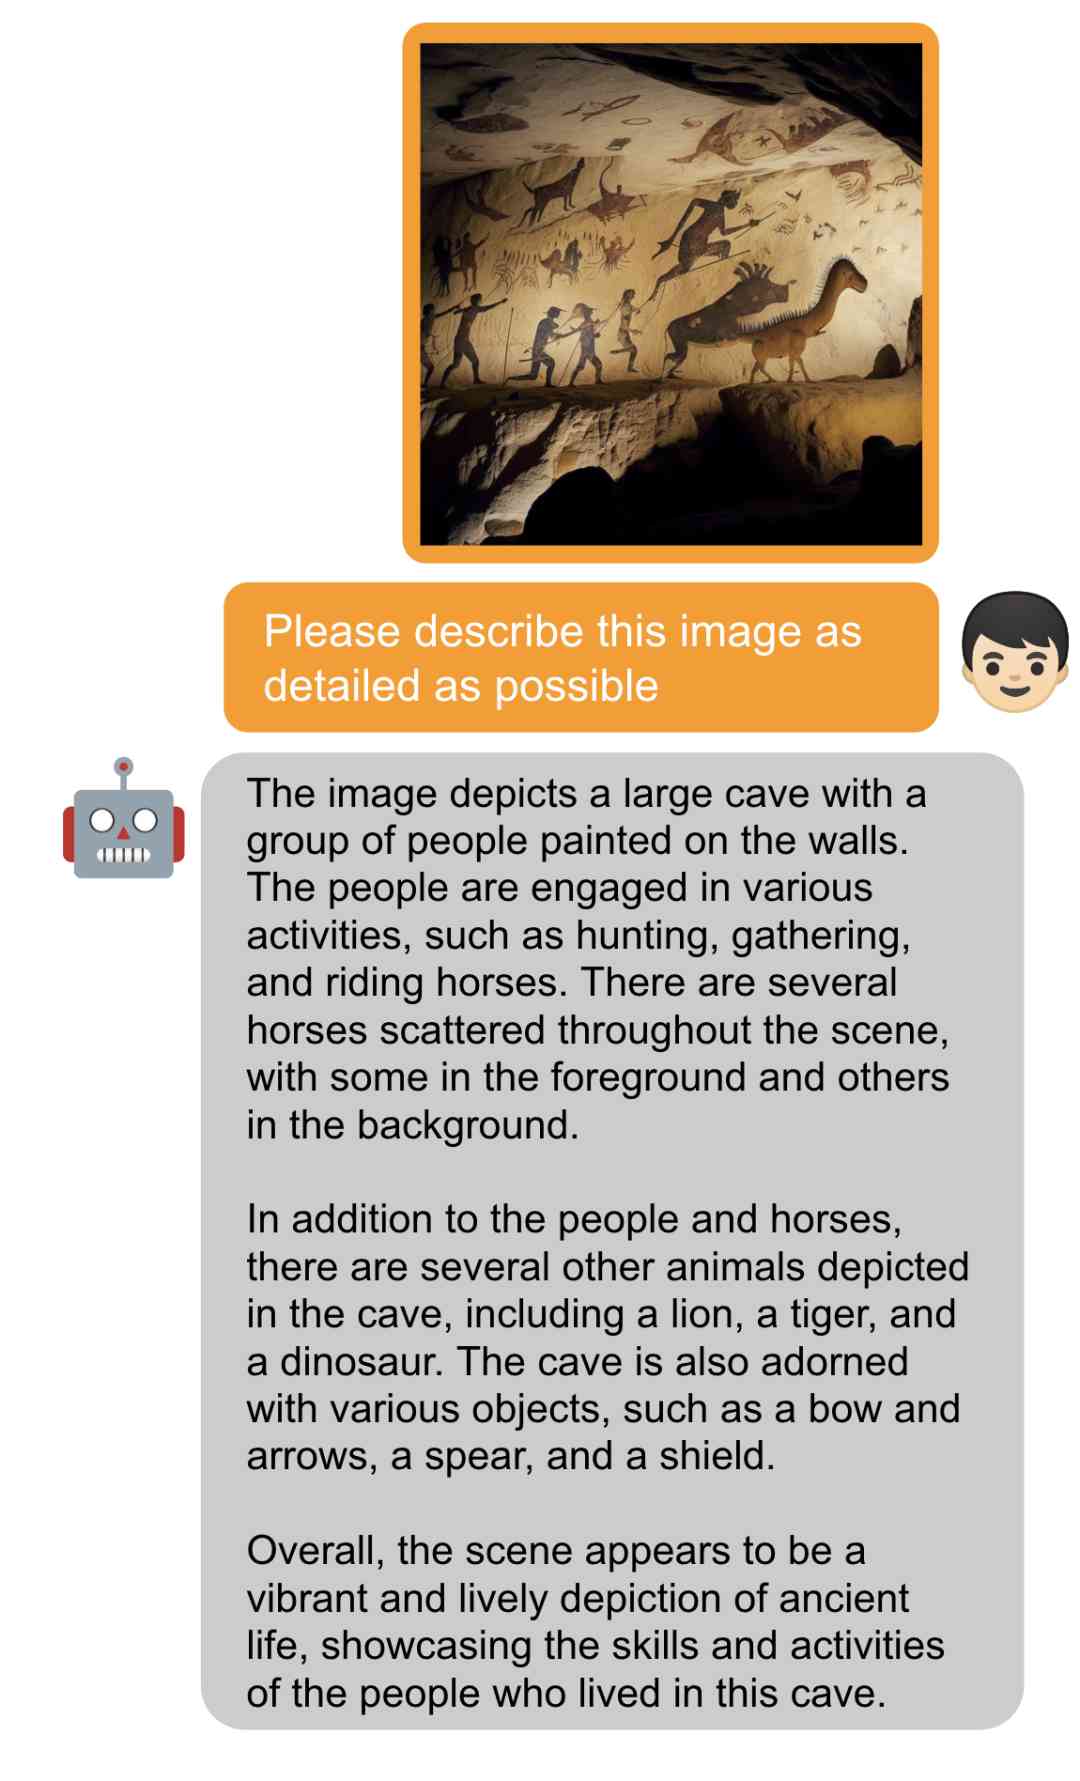
至于"推荐指数。" 和 "最佳使用场景:"
推荐指数这方面,★★★★☆ 最佳使用场景这方面,因为 GTP-T 多模态模式发布,具备识别特定物体名称的大数字化模式变得越来越关键。话说回来,您可以轻松识别特定物体或区域并标注它们。怎么说呢,还可以不加任何任务标识符与图片进行对话。目前,已经提供了免费 Demo。