OpenDataLab 为国产大模型提供高质量的开放数据集
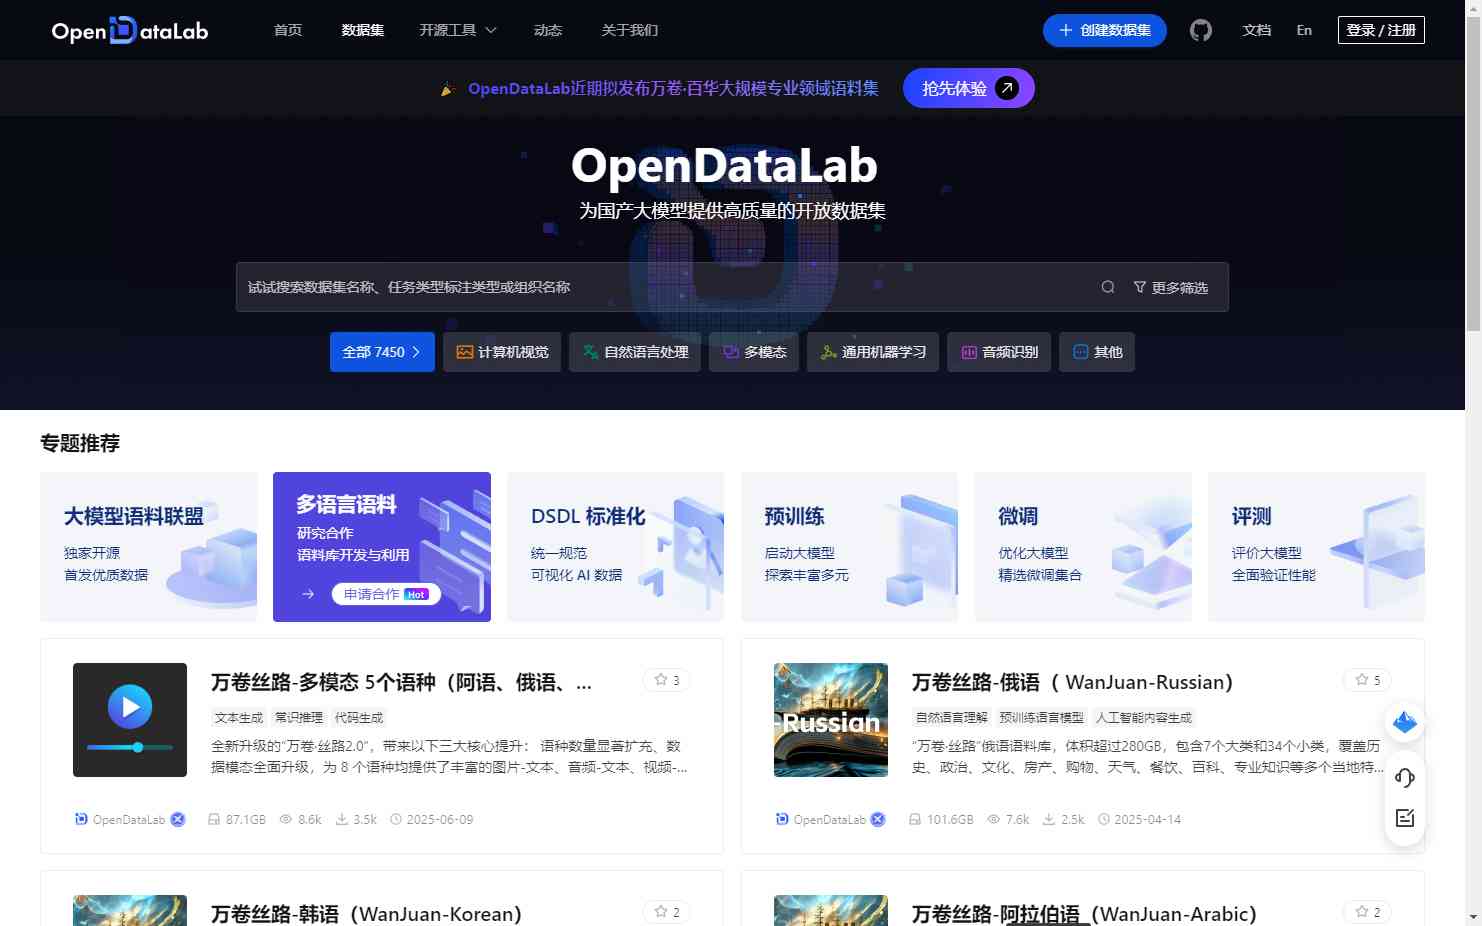
OpenDataLab 是面向国内 AI 研究者、开发者和公司的开放数据集聚合与分发网站。聚焦中文及多模态高质量数据,为国产大模型的预训练、指令微调和评测提供可信数据源。
使用者痛点与需求
找数据难、找对数据更难。AIGC 时代大量团队被困在“数据从哪里来”的问题上。公开网站分散、学术资源门槛高,公司内部数据又受隐私限制,导致项目启动周期被拉长。
数据质量参差不齐。Crawl 数据噪声大、重复率高、标注不一致。训练后出现幻觉、对齐不良等问题频发,研究者需要花费大量时间清洗和筛选。
版权与合规风险高。Hugging Face 等海外资源存在访问不稳定、使用协议模糊的问题。国产团队对数据来源合规性要求严格,却缺乏统一可信的中文库。
Lack of 中文垂直领域语料。VLM、多模态推理等方向急需中文图文对齐、高质量问答对和评测基准,现成资源稀缺且难以复用。
主要功能与优势
Datasets 环境价值体现为实际使用落地支持。同时保持学术开源属性,帮助解决从研究到产品化的数据断层问题,提高整体研发效率与信任度。
Wait I think I duplicated by accident due to thinking errors;need clean version without duplication artifacts. Let me provide clean version again properly without stray duplication.
使用者痛点洞察